音视频及其数字化表示
声音和图像是人类感知世界的两种基本方式,它们的本质基于不同的物理现象。
声音和图像是人类感知世界的两种基本方式,它们的本质基于不同的物理现象。
声音是由物体振动产生的机械波。当物体振动时,周围的空气分子随之振动,形成疏密交替的纵波。这种机械波通过介质(空气、水等)传播,被耳朵中的鼓膜接收,再通过听觉神经转化为我们感知的声音。
声音的特征由两个核心参数决定:
- 频率:决定音调的高低(单位 Hz),人耳可听范围约为 20Hz ~ 20kHz
- 振幅:决定音量的大小(单位 dB)
图像是通过光传递的视觉信息。光是一种电磁波,当它照射到物体表面并反射进入眼睛或摄像机时,我们就能感知到图像。
图像的特征由两个核心参数决定:
- 颜色:由光的波长(频率)决定,可见光波长范围约为 380nm ~ 780nm
- 亮度:由光的强度决定
自然界的声音和光线都是连续的模拟信号。通过数字化处理,可以将这些连续信号转换为离散的数字形式,以便于存储、传输和处理。
数字化后的声音称为音频(Audio),数字化后的图像序列称为视频(Video),合称音视频。
在采集端,音频通过麦克风将声波转换为电信号,视频通过CMOS 图像传感器将光信号转换为电信号,再经由 ADC(模数转换器)转为数字信号存储。
-
采样。连续的模拟音频信号被以固定的时间间隔进行采样,得到一系列离散的采样值。采样的频率决定了每秒采样的次数,通常以赫兹(Hz)为单位。音频的常见采样率是 44.1kHz
-
量化,即用数字来表示音频幅度。量化深度,也称为采样精度,是模拟信号转换为二进制数字信号的位数。量化深度越高,采样的数字信号精度越高。比如,量化深度为 16 bit,采样的数字信号幅度就有
2^16 = 65536个档位。音频量化深度一般有 8 bit、16 bit、20bit、24bit 和 32bit 等。 -
编码(Encoding),即对量化后的数字信号进行压缩编码,以减小数据量。编码分为无损编码(如 FLAC)和有损编码(如 AAC、MP3)。常见的编码格式有
AAC,MP3,G.711,Opus。其中,Opus免费开源,支持从低码率语音到高码率音乐的全场景覆盖,编码效果好,底噪低,逐渐为流媒体所采用。
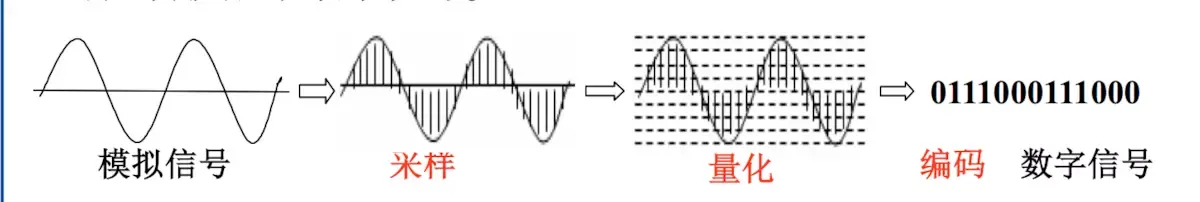
上图中,横坐标代表时间,1 秒钟内竖线的条数对应采样率,竖线的高度对应信号幅度,信号幅度的最小单位的倒数则是量化深度。
| 采样频率(sample rate) | 量化位数(bit depth) | 声道数(Number of Channels) |
|---|---|---|
| 每秒种抽取声音幅度样本的次数 | 每个采样点用多少二进制位表示数据范围 | 声音通道的个数 |
| 采样率越高,声音质量越高,数据量越大 | 量化位数越多,音质越好,数据量越大 | 立体声比单声道表现力更丰富,但数据量翻倍 |
| 常用的采样率: _ 8,000 Hz - 电话所用采样率 _ 11,025 Hz - AM调幅广播所用采样率 _ 22,050 Hz - 无线电广播所用采样率 _ 32,000 Hz - miniDV 所用采样率 * 44,100 Hz - 音频 CD 所用采样率 | _ 8 bit,将幅度划分为 2^8 个等级 _ 16 bit,共 65536 个量级,达到CD标准 * 32 bit,共 4294967296 个量级 | _ 单声道并非意味着只有一个喇叭发声,通常会处理成两个喇叭输出同一个声道的声音 _ 立体声两个喇叭都发声(通常左右声道有分工),更能感受到空间效果。 * 除了单双声道外,还有其他的更多声道,例如 5.1 、7.1 等等 |
-
采样(Sampling): 视频信号是由连续的模拟图像构成的。在采样阶段,图像被以固定间隔的方式采样,将连续图像转换为离散像素点。1 秒中内采样的个数对应视频的帧率
-
量化(Quantization): 对于每个像素,图像的亮度和颜色被量化为数字值。这通常分为亮度量化和色度量化
-
色彩空间转换(Optional): 在某些情况下,视频信号可能需要在不同的色彩空间之间转换,例如从
RGB(Red, Green, Blue)到YUV(Luma, Chroma)。这通常是为了更有效地表示和传输图像信息。因为RGB色彩空间包含了很多人眼无法分辨的色值,且人眼对亮度(明亮度)的敏感性要远远高于对颜色(色度)的敏感性。Y(Luma)表示亮度,U和V(Chroma)表示颜色。通过将颜色信息分离到U和V分量,可以更有效地压缩颜色信息,使其更适合存储和传输 -
编码(Encoding): 最后,编码阶段利用视频编解码器对数据进行压缩。视频编码的核心思想是消除空间冗余(帧内相邻像素的相似性)和时间冗余(相邻帧之间的相似性)。常见的编码格式包括
AVC(H.264)、HEVC(H.265)、VP9、AV1。其中 H.264 目前仍是兼容性最广的格式,而 H.265 和 AV1 在同等画质下能节省约 30%~50% 的码率
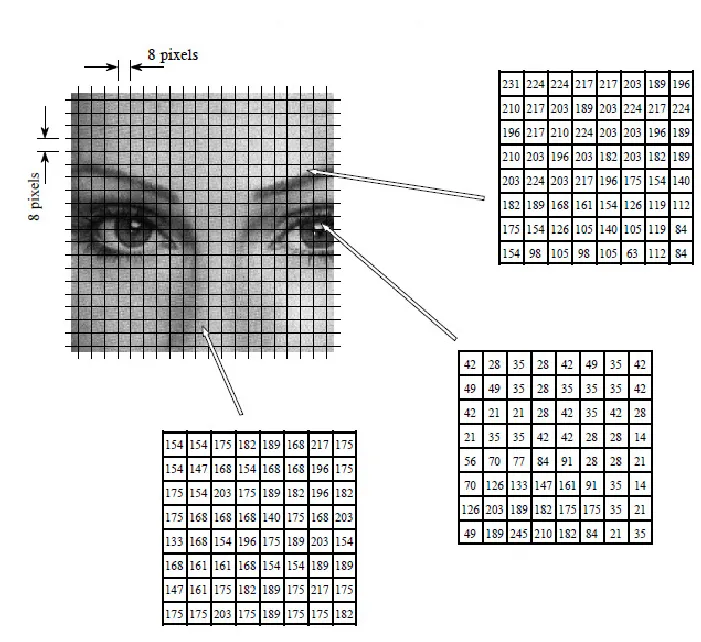
上图是 H.264 编码的示意图,每幅图像被分割成 8*8 像素尺寸来编码。
色彩空间(Color space)是对色彩的组织方式。色彩模型(Color model)是一种抽象数学模型,通过一组数字来描述颜色(例如RGB使用三元组、CMYK使用四元组)。由于“色彩空间”有着固定的色彩模型和映射函数组合,非正式场合下,这一词汇也被用来指代色彩模型。常见的色彩模型包括 RGB,YUV(YCbCr),HSV,HSL,CMYK 等。下面我们重点介绍 YUV 色彩模型。
YUV 是一种表示颜色的模型。但是我们常说的 YUV ,其实指的是 YCbCr,其中Y是指亮度分量,Cb指蓝色色度分量,而Cr指红色色度分量,是标准 YUV 的一个翻版,此文中,我们就用 YUV 指代 YCbCr 了。
YUV 格式按照数据大小分为三个格式,YUV 420,YUV 422,YUV 444。由于人眼对 Y 的敏感度远超于对 U 和 V 的敏感,所以有时候可以多个 Y 分量共用一组 UV,这样既可以极大得节省空间,又可以不太损失质量。
YUV 420,由 4 个Y分量共用一套UV分量YUV 422,由 2 个Y分量共用一套UV分量YUV 444,不共用,一个Y分量使用一套UV分量
在这三种类型之下,我们又可以按照 YUV 的排列储存顺序,将其细分为好多种格式。按照 YUV 的排列方式,再次将 YUV 分成三个大类,Planar,Semi-Planar 和 Packed。
- Planar YUV 三个分量分开存放
- Semi-Planar Y 分量单独存放,UV 分量交错存放
- Packed YUV 三个分量全部交错存放
H.264 编码有两种 Byte Stream Format,分别是 AnnexB 和 AVCC。
AnnexB format:([start code] NALU) | ( [start code] NALU) |AVCC format:([extradata]) | ([length] NALU) | ([length] NALU) |In annexb, [start code] may be 0x000001 or 0x00000001. In avcc, the bytes of [length] depends on NALULengthSizeMinusOne in avcc extradata, the value of [length] depends on the size of following NALU and in both annexb and avcc format, the NALUs are no different.
Annex B 多用于网络流媒体中:rtmp、rtp 格式,AVCC 多用于文件存储中mp4的格式
H.265 编码和 H.264 不同,其 Byte Stream Format 包含 H.265 Annex B 和 H.265 Parameter Sets
我们可以使用 ffmpeg 提供的 ffprobe 工具来查看视频文件信息。
从下图中高亮部分可以看到,该视频文件为 mp4 文件,时长 7.62 秒,码率为 13805 kb/s,包含了 2 条 Stream。
其中, Video 使用 H.264 编码,色彩空间为 yuv420,分辨率为 1080P(1920*1080),帧率为 29.97,
Audio 使用 aac 编码,采样率为 44.1kHz,立体声
1080p是一种视频分辨率标准,指的是视频的垂直分辨率为1080像素。具体来说,1080p视频的分辨率为1920x1080,其中1920是水平像素数,1080是垂直像素数。字母“p”代表“逐行扫描”(progressive scan)的意思。这意味着视频的每一帧都是通过扫描整个图像的每一行像素来创建的,而不是通过交替扫描奇数和偶数行像素来创建的。与交替扫描的“隔行扫描”(interlaced scan)相比,逐行扫描可以提供更清晰的图像,因为它可以更好地保留运动图像中的细节和清晰度。
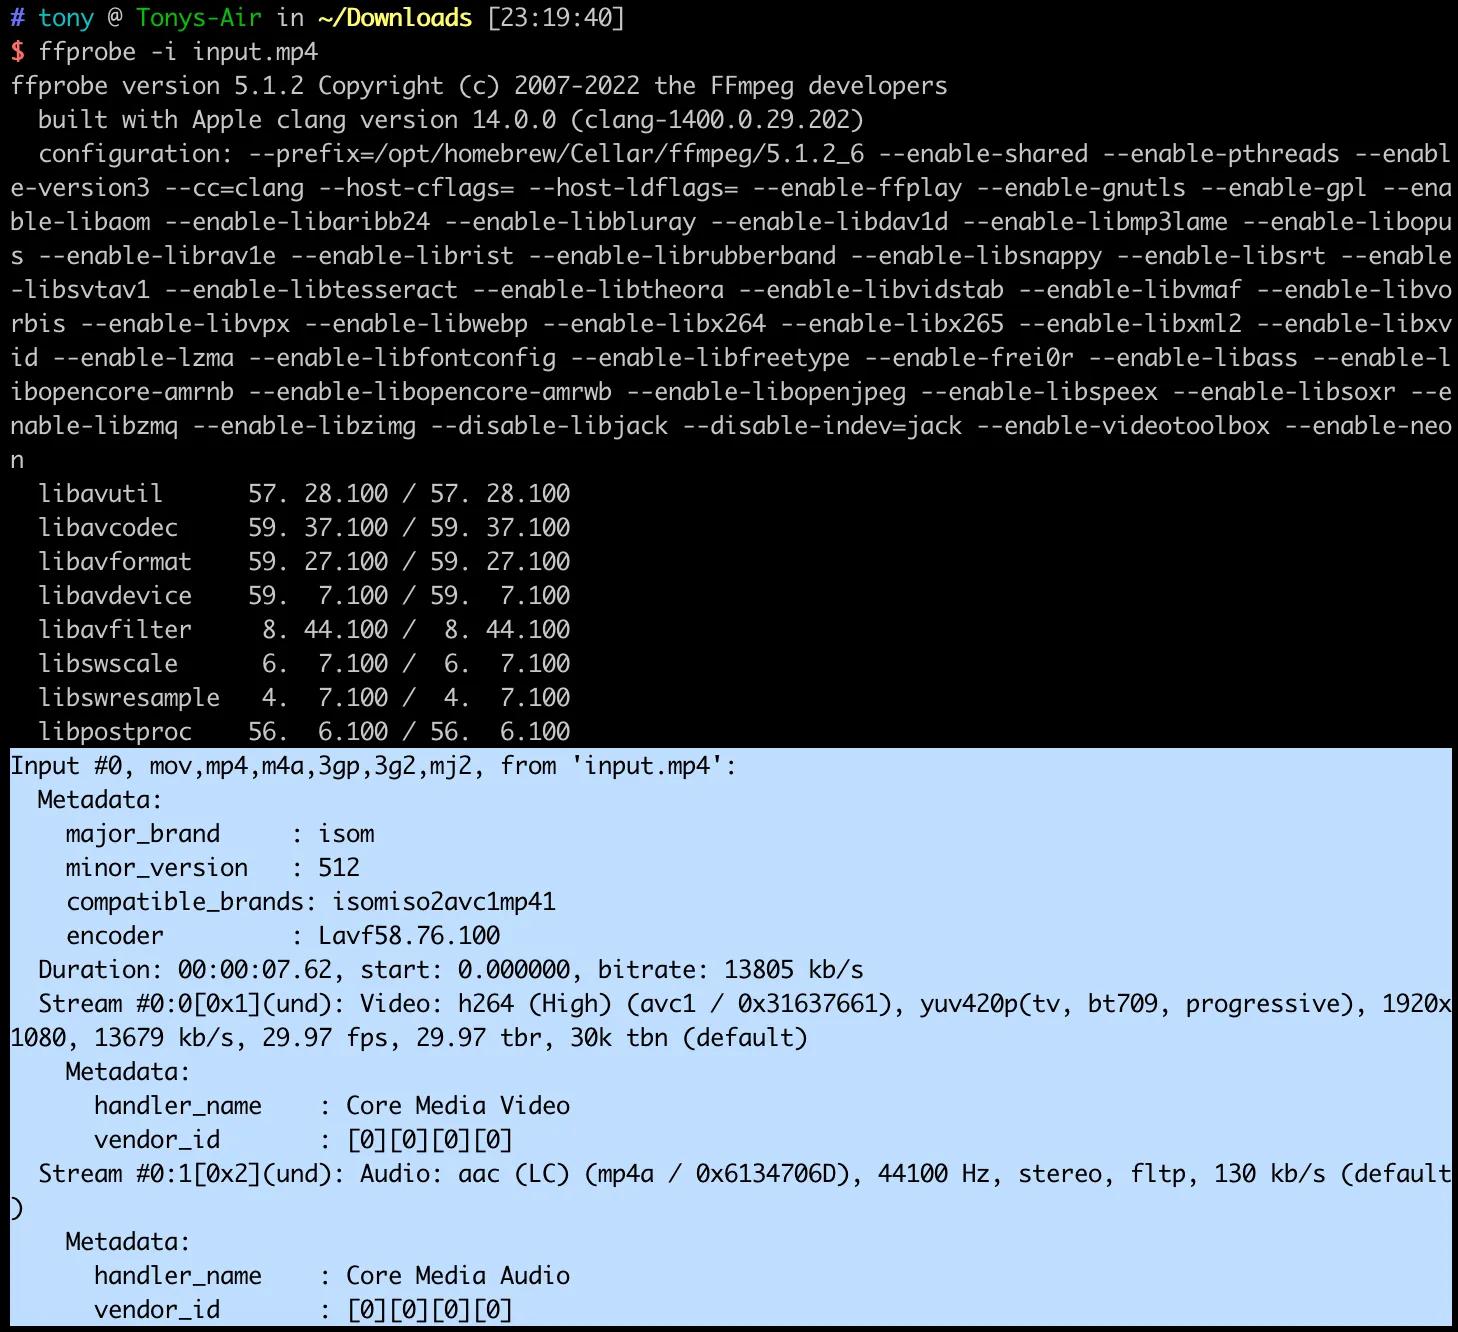
那段信息是 mp4 文件的 metadata(元数据),存储在 mp4 容器的 moov box 中。常见字段包括:
major_brand:文件的主要品牌标识(如isom、mp42),标明文件遵循的 mp4 规范版本minor_version:次要版本号compatible_brands:兼容的品牌列表,表示该文件可被哪些解码器/播放器正确解析encoder:编码该文件的软件(如Lavf58.29.100表示 FFmpeg 的 libavformat 库)creation_time、duration等时间信息
这些元数据帮助播放器在解码前快速了解文件结构,从而选择正确的解复用(demux)和解码策略。
前文已经介绍了 YUV 格式的分类。这里进一步解释 YUV420 的含义:
“420”中的数字表示在 4 个像素的采样中,Y、Cb、Cr 各分量的采样比例。具体地:
- 每行 4 个像素都有独立的 Y(亮度)值
- 每 2×2 的像素块共享 1 组 Cb 和 Cr 值
- 即色度在水平和垂直方向上都做了 2:1 的下采样
数据量对比:
- YUV444:每像素 3 字节(Y+U+V 各 1 字节),总计
width × height × 3 - YUV420:每像素平均 1.5 字节(Y 占 1 字节,U 和 V 各占 0.25 字节),总计
width × height × 1.5
YUV420 相比 YUV444 节省了 50% 的存储空间,而由于人眼对色度变化不敏感,画质损失几乎不可察觉。这也是为什么绝大多数视频编码(H.264、H.265、VP9 等)默认使用 YUV420 格式。
示例中的帧率为 29.97 fps 而非 30 fps,这源于 NTSC 彩色电视制式的历史遗留。
1950 年代,美国黑白电视标准为 30 fps(基于 60Hz 交流电频率)。当引入彩色信号时,为了与已有的黑白电视信号兼容,工程师需要在原有带宽中同时传输亮度和色度信息。为避免色度副载波与音频载波之间产生干扰(beat interference),将帧率从 30 fps 略微降低了 0.1%,即:
这个 1000/1001 的比例一直沿用至今。类似地,24fps 的电影在 NTSC 制式下变为 23.976 fps,60fps 变为 59.94 fps。
在数字视频中,帧率通常用分数表示以保证精确:如 30000/1001 而非浮点数 29.97。FFmpeg 中的 time_base 和 r_frame_rate 字段正是用这种分数形式来避免浮点精度问题。
参考资料